Blog · Tin AI Agent · AI video VIEN
Apple tung FastFrames: Sinh video AI 35,4 ms trên 1 GPU
Nhóm nghiên cứu Apple mở mã nguồn FastFrames (14B và 1.3B), kéo độ trễ sinh video AI xuống 35,4 ms trên 1 GPU. Xem cách họ tháo nút thắt và giới hạn phần cứng.
Trong bài này
Thường bấm tạo một đoạn video AI xong là bạn phải đi pha ly cà phê quay lại mới thấy kết quả, nhưng tháng 11/2026 nhóm nghiên cứu AIML của Apple vừa công bố FastFrames — họ mô hình mở kéo độ trễ sinh video 480p xuống còn 35,4 ms trên một GPU duy nhất. Thay vì chỉ nén lõi diffusion như cách làm cũ, Apple xử lý thẳng hai khâu hay bị bỏ quên là giải mã hình ảnh và cập nhật bộ nhớ đệm.
FastFrames-S (1.3B) và FastFrames-L (14B) khác nhau chỗ nào?
Apple tung ra cùng lúc hai biến thể mô hình video tự hồi quy hai bước (two-step autoregressive video diffusion) để phục vụ hai nhu cầu rõ ràng, từ phản hồi tức thì tới chất lượng hình ảnh cao hơn cho mô hình mô phỏng thế giới tương tác. Cả hai đều xuất video 832 × 480 (81 khung hình ở tốc độ 16 fps).
- FastFrames-S (1,3 tỷ tham số): Giữ nguyên bộ sinh hai bước
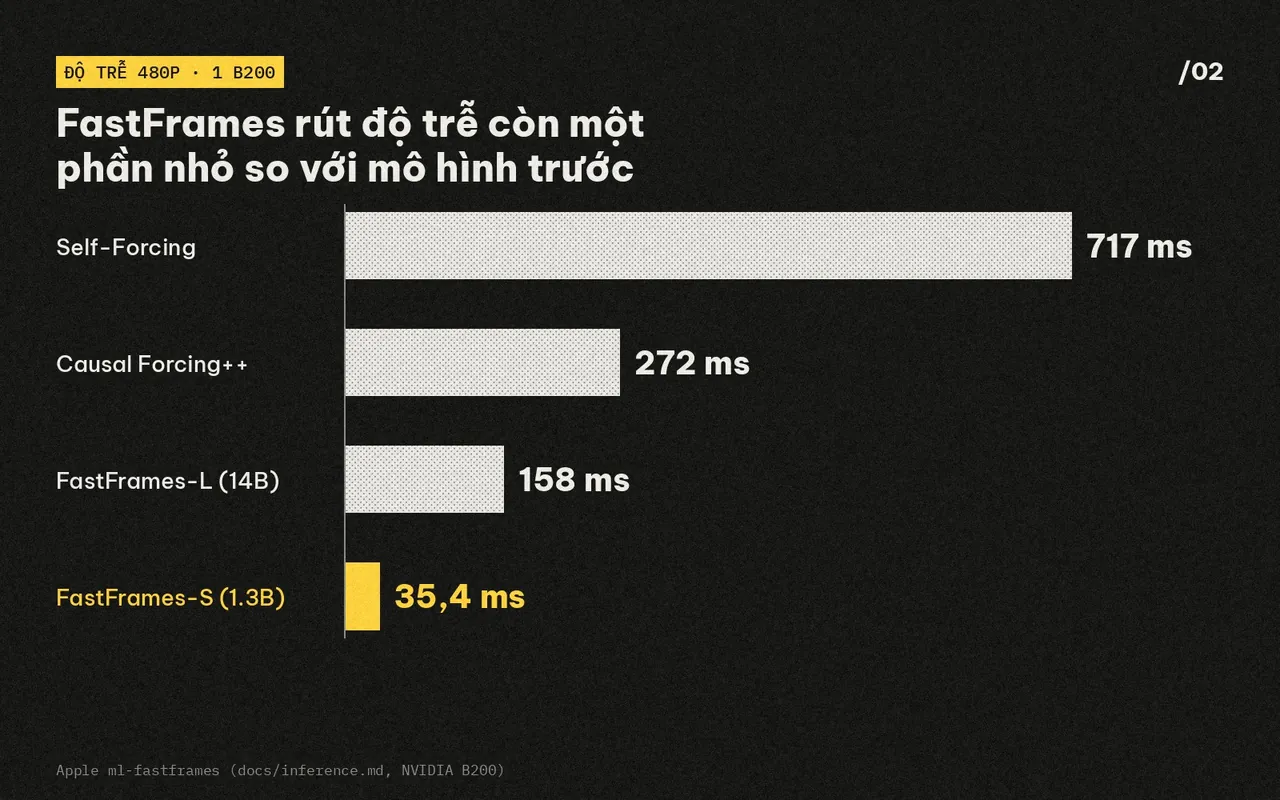
Causal Forcing++và chỉ huấn luyện phần mạng giải mã pixel cùng bộ tinh chỉnh bộ nhớ đệm. Nhờ gọn nhẹ, bản này chạy hết một bước sinh 4 khung hình RGB chỉ trong 35,4 ms trên 1 GPU B200 (hoặc 14 ms nếu chia lên 8 GPU), rất hợp cho các tác vụ điều khiển camera theo thời gian thực. - FastFrames-L (14 tỷ tham số): Chưng cất từ mô hình nền
Wan2.1-T2V-14B, cho ánh sáng, đổ bóng, bố cục và khả năng dựng chữ trong khung hình sắc nét hơn hẳn bản nhỏ. Một bước chạy trên 1 GPU B200 mất 158 ms (còn 45 ms trên cụm 8 GPU), ngang ngửa chất lượng của Krea-Realtime nhưng nhanh hơn gấp 10 lần. - LingBot 1.3B bản tối ưu: Đi kèm kho mã nguồn là phiên bản
LingBot-World v2 1.3Bđược áp dụng kỹ thuật của FastFrames, đạt tốc độ nhanh gấp 16 lần bản gốc của hãng để người dùng bấm phím W/A/S/D xoay góc máy mượt mà trên trình duyệt.
| Mô hình | VBench Tổng | VBench Chất lượng | Độ trễ 1 GPU (B200) | Độ trễ 8 GPU (B200) |
|---|---|---|---|---|
| CausVid | 83,18 | 84,15 | — | — |
| Self-Forcing | 84,10 | 84,84 | 717 ms | — |
| Causal Forcing++ | 84,11 | 85,09 | 272 ms | — |
| FastFrames-S (1.3B) | 84,23 | 85,30 | 35,4 ms (paper: 36 ms) | 14 ms |
| FastFrames-L (14B) | 84,44 | 85,48 | 158 ms | 45 ms |
Apple tháo hai nút thắt cổ chai nào để xuống 35,4 ms?
Trước giờ nhiều nhóm nghiên cứu chỉ lo ép số bước khử nhiễu (denoising steps) của lõi DiT xuống thấp nhất có thể, nhưng khi đo thời gian từng khâu (profiling), nhóm Apple phát hiện chính hai bước đứng sau mới ngốn phần lớn thời gian chờ của hệ thống.
flowchart LR
  A[DiT 2 bước: 32,3 ms]:::data --> B[KV refinement: 2,2 ms]
  B --> C[Pixel decoder: 0,9 ms]:::key
  C --> D[4 khung hình 480p]
  classDef key fill:#1d1a10,stroke:#ffd23f,color:#ffd23f,stroke-width:1.6px
  classDef human fill:#181817,stroke:#e8e6df,color:#e8e6df,stroke-dasharray:5 3
  classDef data fill:#1c1c1b,stroke:#8d8b85,color:#cfcdc6
  classDef muted fill:#181817,stroke:#3d3d3a,color:#8d8b85
Nút thắt thứ nhất là VAE decoding (bộ giải mã biến dữ liệu nén thành khung hình pixel thật để mắt nhìn thấy). Ở các mô hình cũ, mỗi lần xuất một khối khung hình ngắn, bộ giải mã VAE mặc định chạy chậm rì làm nghẽn cả đường ống. Apple thay thẳng khâu này bằng một pixel decoder chuyên biệt kiểu streaming, kéo thời gian giải mã xuống chỉ còn 0,9 ms cho mỗi lần gọi.
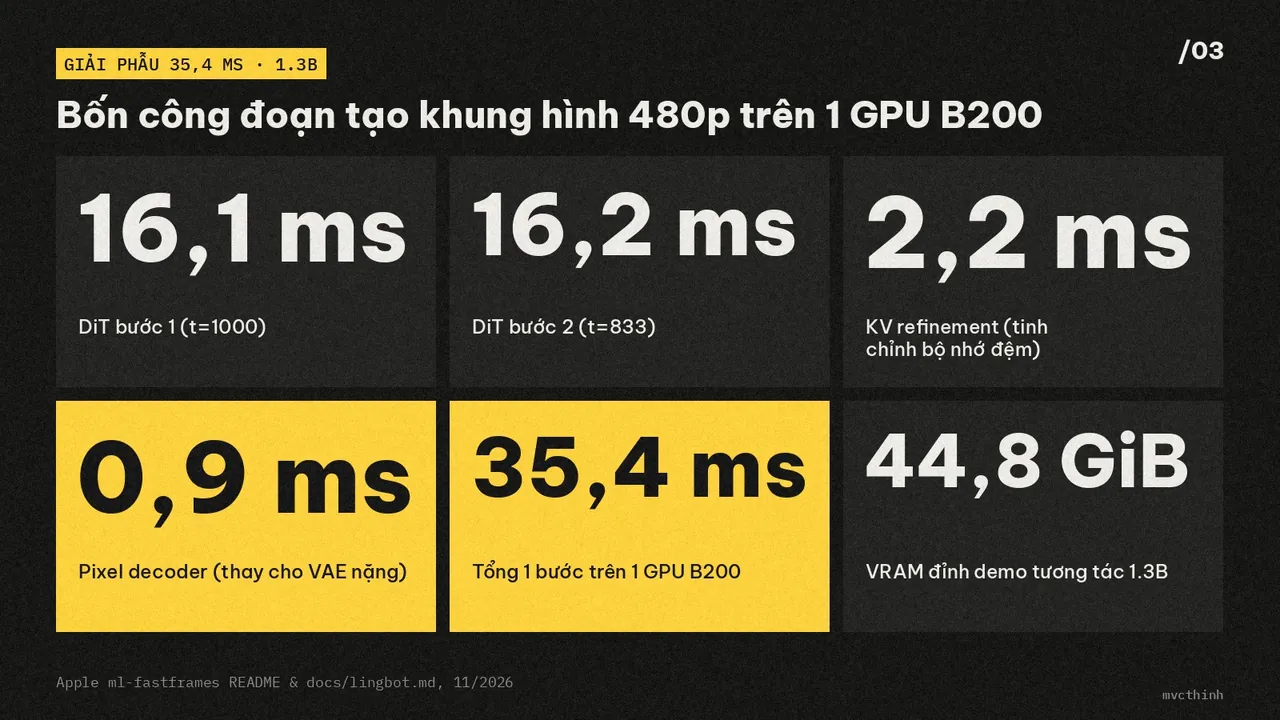
Nút thắt thứ hai là KV cache updates (bước cập nhật bộ nhớ đệm giữ ngữ cảnh các khung hình trước đó để video không bị giật hay quên nhân vật). Thay vì tốn thêm một lượt chạy DiT nặng nề chỉ để ghi lại bộ nhớ đệm sạch như cách làm của Causal Forcing++, FastFrames gắn thêm một mạng KV refinement gọn nhẹ chỉ mất 2,2 ms. Nhờ gọt sạch hai phần rìa này, tổng thời gian cho 2 lượt đánh giá DiT (16,1 ms và 16,2 ms) cộng với tinh chỉnh KV và giải mã pixel khớp đúng 35,4 ms.
 Đọc thêmMình thử dùng Opus 5.5 biến ảnh 2D thành cảnh 3D ngay trong toEdit
Người dựng video chạy AI tại máy cần chờ gì?
Dù độ trễ mili-giây nhìn rất đã mắt, anh em dùng Mac Apple Silicon hay card đồ họa 8–16 GB VRAM chưa thể tải về bấm chạy mượt ngay tại nhà trong ngày một ngày hai. Toàn bộ mốc 35,4 ms đều được đo trong điều kiện phòng lab rất gắt.
Thế nên, để người dùng cá nhân tận dụng được tốc độ này ở nhà, cộng đồng mã nguồn mở vẫn phải chờ các bản lượng tử hóa (nén trọng số xuống FP8 hoặc INT4) cho card phổ thông hoặc bản chuyển sang MLX trên máy Mac. Tuy nhiên, việc Apple công khai kiến trúc tháo nút thắt này vẫn cực kỳ đáng giá, nhất là trong bối cảnh chi phí phần cứng và giá RAM phục vụ AI đang leo thang, còn sức mạnh hệ sinh thái lập trình trên GPU NVIDIA và nền tảng CUDA vẫn là điều kiện bắt buộc của hầu hết mô hình video mới.
Tương lai của dựng nháp thời gian thực
Nói thiệt nha, với người làm nội dung và dựng phim, thứ tốn thời gian nhất khi xài video AI hiện giờ không phải lúc render bản cuối mà là khâu thử ý tưởng. Mỗi lần gõ một prompt rồi ngồi ngó màn hình xoay vòng 1–2 phút, nhiều khi đứt luôn mạch sáng tạo mà tốn cả mớ credit nếu khung hình ra sai góc máy.
Khi độ trễ sinh khung hình tụt về mức vài chục mili-giây, AI bắt đầu chuyển từ công cụ "bấm rồi chờ" sang công cụ phác thảo tương tác trực tiếp. Dù bản chạy nhẹ trên máy cá nhân 8–16 GB VRAM hay Mac Silicon còn cần thêm thời gian tối ưu, hướng cắt thẳng vào pixel decoder và KV cache của Apple cho thấy ngày anh em kéo góc máy storyboard trực tiếp ngay trên máy nhà không còn xa nữa.
Nguồn
Cùng chủ đề
 An toàn & chính sách · 21/11/2026Thiếu Jensen Huang, tương lai Nvidia và CUDA sẽ ra sao?
Phân tích Nvidia hậu Jensen Huang: khoảng trống 60 đầu mối, sức ép từ AMD và Claude Mythos lên CUDA, cùng tác…
 AI video · 20/11/2026Driver NVIDIA bị tố ghi SSD tới 30 GB/giờ: kiểm tra nhanh
Người dùng báo GeForce 621.14/621.24 ghi 3–30 GB/giờ khi PC rảnh. Cách soi NVDisplay.Container.exe và cân nhắc quay về driver 621.01.
 MCP & công cụ · 19/11/2026Search Browser 10,8 MB vs Chrome: Đáng đổi trên Mac không?
Đánh giá thực dụng Search Browser v1.0.14 (nhân WebKit) so với Chrome trên Mac: số đo tốc độ, RAM, tính năng thay…